Uma equipe de 10 mil agentes de inteligência artificial da OpenAI teria produzido uma prova para o problema de Navier-Stokes, um dos sete "Problemas do Milênio" com prêmio de US$ 1 milhão. Mas a comemoração durou pouco: um matemático da Universidade de Nova York (NYU) acusa a empresa de ter se apropriado de sua pesquisa não publicada e de pressioná-lo sobre os créditos da descoberta.
O anúncio e o alcance da prova
Na terça-feira (8/9), a OpenAI anunciou que um modelo de inteligência artificial interno, ainda não lançado publicamente e descrito como "significativamente mais capaz" que o GPT-6 Astra (seu modelo mais avançado disponível ao público), produziu uma prova para o problema de existência e suavidade de Navier-Stokes — um dos sete "Problemas do Milênio" definidos pelo Clay Mathematics Institute em 2000, cada um com prêmio de US$ 1 milhão para quem o resolver.
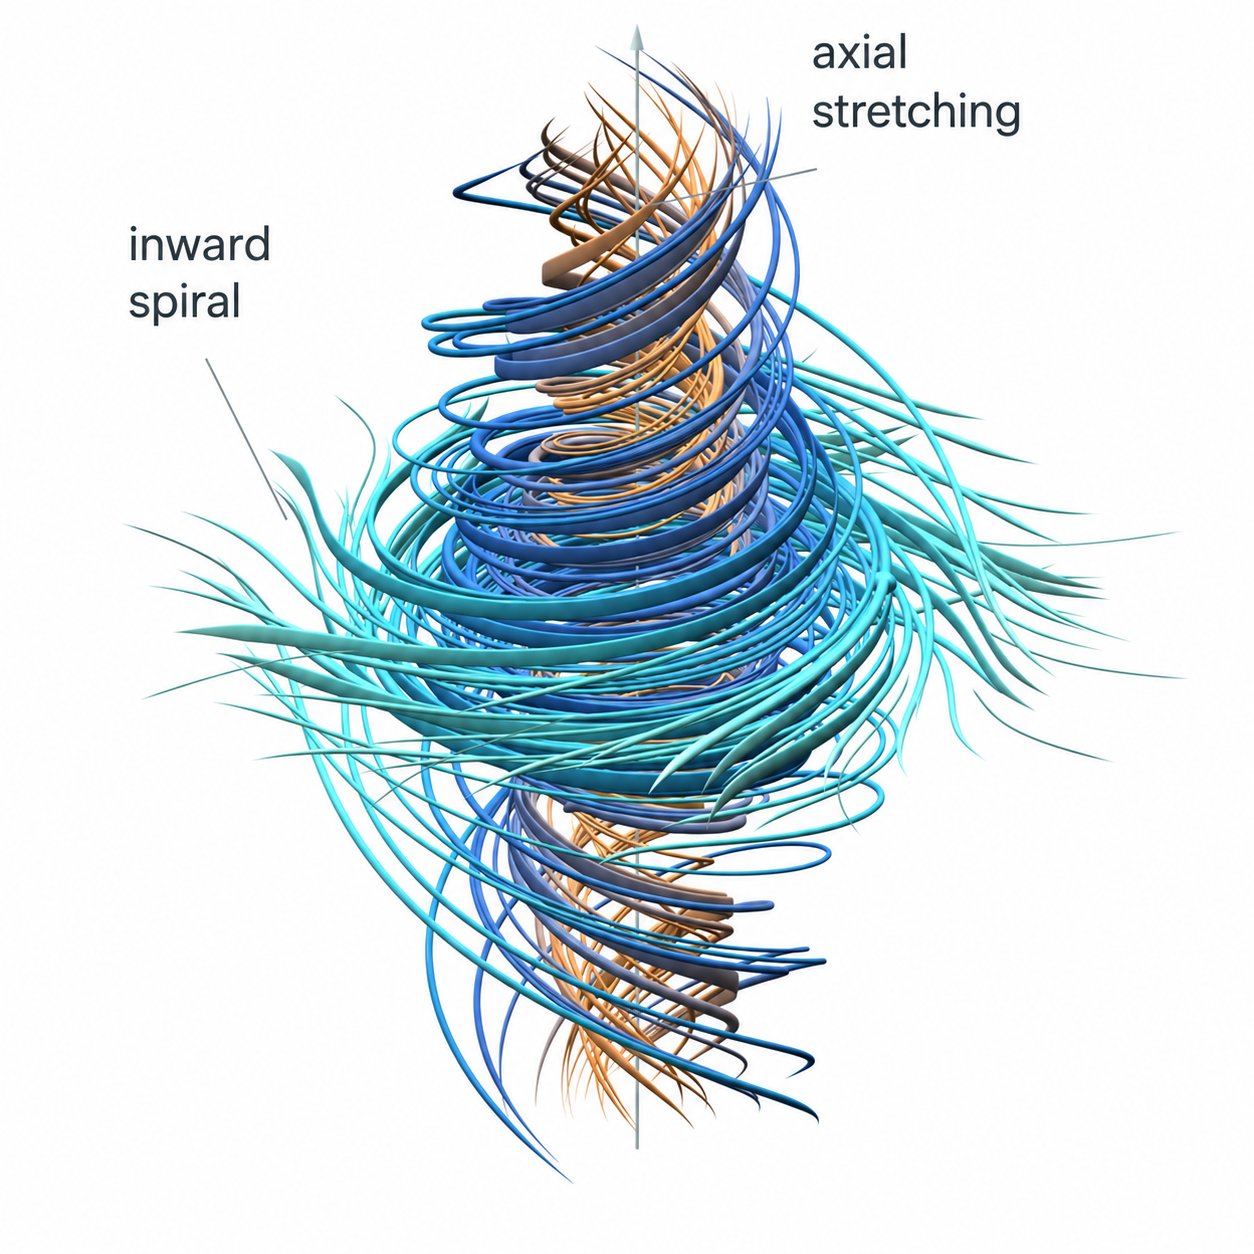
As equações de Navier-Stokes descrevem como fluidos como água e ar se movimentam e são usadas em áreas como previsão do tempo, projeto de aeronaves e estudo do fluxo sanguíneo. A questão em aberto há quase 90 anos era saber se um fluxo suave e tridimensional pode, em certas condições, entrar em colapso e gerar uma "singularidade" — um ponto em que a velocidade do fluido cresceria infinitamente em um intervalo de tempo finito, o que, na física real, não pode acontecer.
Segundo a OpenAI, a prova descreve exatamente esse cenário: um vórtice de fluido que se estica e se concentra até que sua velocidade "exploda" em tempo finito, mesmo com a energia total do sistema permanecendo finita.
Uma operação em escala industrial
O que chama atenção não é só o resultado, mas a forma como ele foi obtido. Segundo o próprio comunicado da OpenAI, o esforço começou em 1º de setembro, depois que pesquisadores da empresa ouviram rumores de que dois Problemas do Milênio tinham sido resolvidos por um grupo ligado à Anthropic. A partir daí, a OpenAI lançou seu modelo interno mais avançado sobre os problemas em aberto.
Os agentes foram organizados em grupos com capacidade de comunicação interna, testando diferentes variações do enunciado do problema. Quase 100 agentes trabalharam por cerca de 50 horas em uma versão relacionada às equações de Euler (que não incluem o termo de viscosidade presente em Navier-Stokes) antes que a OpenAI concentrasse recursos no problema principal.
Na fase decisiva, o grupo que produziu a resolução de Navier-Stokes chegou a operar com cerca de 10 mil agentes simultâneos. Para evitar que cada grupo trabalhasse isoladamente, a OpenAI usou seu modelo Codex para "polinizar" as equipes — consolidando os insights mais promissores encontrados por diferentes grupos e redistribuindo-os em novos prompts.
Os números divulgados pela empresa são expressivos:
- Os agentes chegaram à resolução em 5 de setembro, cerca de 88 horas depois do início do trabalho;
- A formalização e verificação da prova na linguagem Lean (usada para checar matematicamente resultados) levou mais 17 horas, com o modelo GPT-6 Astra;
- Só para o Navier-Stokes, os agentes trocaram 2,7 milhões de mensagens e geraram cerca de 130 bilhões de tokens de saída;
- Somando todos os problemas matemáticos que a OpenAI tentou resolver na mesma leva, o total sobe para 4,9 milhões de mensagens e aproximadamente 300 bilhões de tokens.
Em uma chamada com jornalistas, executivos da OpenAI estimaram o custo do esforço na casa dos "milhões de dólares", sem detalhar um valor exato. Com base na tabela de preços pública do modelo Astra, veículos como o Dataconomy calcularam que os 300 bilhões de tokens gerados equivaleriam a cerca de US$ 22,5 milhões, enquanto outras estimativas, considerando apenas o trabalho em Navier-Stokes, apontam para algo próximo de US$ 10 milhões. São contas feitas pela imprensa a partir de dados públicos de uso — a OpenAI não confirmou nenhum valor exato.
Apesar do anúncio, é importante frisar: o Clay Mathematics Institute continua listando o problema de Navier-Stokes como não resolvido. A OpenAI publicou um artigo técnico e a prova formal em Lean, mas o resultado ainda depende de revisão e validação pela comunidade matemática internacional antes de qualquer reconhecimento oficial — e a própria empresa afirmou que não vai reivindicar o prêmio de US$ 1 milhão.
A polêmica: acusações de pressão e uso indevido de dados
O anúncio, que poderia ter sido um marco tranquilo para a aplicação de IA à pesquisa científica, foi imediatamente ofuscado por uma disputa pública envolvendo créditos e ética.
Horas antes da publicação oficial da OpenAI, o matemático Tristan Buckmaster, professor da NYU, divulgou um relato detalhado acusando a empresa de conduta antiética. Segundo Buckmaster, ele e Levent Alpöge — pesquisador vinculado à Anthropic, mas atuando no projeto em caráter pessoal — vinham trabalhando havia quase um ano em uma abordagem para o problema, baseada em uma linha de ataque desenvolvida originalmente pelos matemáticos Diego Córdoba e Luis Martínez-Zoroa. A dupla teria feito progresso lento até meados de agosto, quando o uso intensivo de modelos de IA — incluindo o Claude da Anthropic e o Codex e o Astra da própria OpenAI — acelerou o trabalho.
Buckmaster e Alpöge chegaram a publicar provas, verificadas em Lean, de "blow-up em tempo finito" (com forçamento suave) para equações relacionadas — meios porosos incompressíveis, Boussinesq e Euler 3D incompressível — o que o matemático Terence Tao, da UCLA, chamou de "uma conquista notável". A versão mais avançada da dupla, mais próxima do problema completo de Navier-Stokes, ainda não havia sido publicada, pendente de uma verificação final em Lean.
Segundo o relato de Buckmaster, em 3 de setembro — em meio aos rumores de que a Anthropic estaria perto de uma solução — ele contatou um matemático da OpenAI para relatar o andamento do projeto, deixando claro que se tratava de um trabalho pessoal, não afiliado a nenhuma das duas empresas. Três dias depois, em uma ligação, o pesquisador da OpenAI Sébastien Bubeck teria dito a Buckmaster que um modelo interno já havia produzido uma prova de 100 páginas para uma versão "forçada" de Navier-Stokes — a mesma abordagem estreita que, segundo Buckmaster, quase ninguém mais estava seguindo.
De acordo com o matemático, Bubeck ofereceu então duas opções: ou a OpenAI publicaria um dia depois da equipe de Buckmaster, ou ele poderia escrever seu artigo sozinho, deixando Alpöge fora da autoria por trabalhar em um laboratório rival. Quando Buckmaster disse que tornaria a conversa pública, ele afirma que Bubeck respondeu: "Por que você estragaria sua carreira?" — e, em outro momento: "Se você não quer que eu seja gentil, eu não preciso ser gentil."
Buckmaster também levantou uma suspeita mais grave: ele e Alpöge usaram intensamente o Codex, ferramenta da própria OpenAI, para registrar rascunhos do projeto. Como a empresa reserva o direito de treinar modelos com base em interações no Codex — a menos que o usuário opte por não permitir —, Buckmaster questionou diretamente se o modelo interno da OpenAI havia sido treinado com, ou teve acesso a, essas sessões. Segundo ele, a resposta foi evasiva: "Fui informado de que o modelo não consulta dados de usuários. Perguntei novamente, sobre treinamento, e não obtive resposta."
A resposta da OpenAI
A OpenAI e seus executivos rejeitaram a versão de Buckmaster. Em nota pública, a empresa afirmou: "Nós (os pesquisadores e os agentes) não vimos nenhum trabalho deles [Buckmaster e Alpöge] por nenhum meio até que fosse divulgado publicamente — em particular, nenhum dado específico de usuário foi acessado para resolver este problema." A empresa reconheceu, porém, que não pode descartar completamente que dados anonimizados (des-identificados), derivados do uso de seus produtos, possam ter contribuído indiretamente para o aprimoramento de seus modelos.
Sébastien Bubeck classificou publicamente as acusações de Buckmaster como "falsas e inflamatórias" e publicou prints de mensagens que, segundo ele, provam que ofereceu à equipe de Buckmaster a opção de publicar primeiro. Bubeck alegou ainda que jamais pediu a exclusão de Alpöge da autoria do próprio trabalho do pesquisador.
O CEO da OpenAI, Sam Altman, também saiu em defesa de Bubeck, afirmando ter passado boa parte do fim de semana conversando com a equipe envolvida: "Seb — e todos os outros — agiram com integridade e generosidade o tempo todo. Inicialmente acreditávamos que a outra equipe também havia resolvido o problema. Queríamos colaborar e fazer um lançamento conjunto", disse Altman, segundo relatos da imprensa. A OpenAI afirma ainda que, ao perceber que Buckmaster e Alpöge haviam resolvido apenas a versão de Euler — e não o Navier-Stokes completo —, ofereceu a eles a opção de publicar primeiro.
Vale notar que a origem de toda a corrida, segundo a própria OpenAI admite em seu comunicado, foi um boato: a empresa decidiu dedicar recursos massivos ao problema depois de rumores de que a Anthropic estaria perto de resolver dois Problemas do Milênio. Também nesta mesma semana, a Anthropic anunciou que seu modelo Claude produziu uma prova verificada por computador relacionada ao Último Teorema de Fermat — o que reforça a leitura de que a disputa entre os dois laboratórios está, cada vez mais, sendo travada no terreno da matemática pura como vitrine de capacidade técnica.
A repercussão nas redes sociais
A história se espalhou rapidamente no X (antigo Twitter), com usuários resumindo — e questionando — a linha do tempo dos acontecimentos. O usuário Nik (@ns123abc), em uma publicação com mais de 4 milhões de visualizações, sintetizou a cronologia da forma como Buckmaster a descreveu:
"math professor spends a year on one of the hardest unsolved problems in math >'Navier-Stokes' >his drafts for the whole project went through codex sessions >openai had his logs in codex >suddenly rumor leaks AI solved it >he emails openai to ask what's going on >openai calls within days >'funny story, our model also solved it' >using his exact approach >asks openai: did you train on my sessions? >no answer"
Horas depois, o mesmo usuário publicou uma segunda thread, ainda mais direta em relação às acusações contra a empresa:
"sam altman: 'we tried this because there were rumor on the internet' >rumor: math professor close to solving navier-stokes >the professor: using codex for a year >openai: has all his logs >checked every codex session tagged to N-S >found the most promising one >spun up 10,000 agents to finish the proof where he couldn't >they got caught >told the guy if you say anything you'll destroy your own career >he ruins his career over this >openai: 'we did not see his work' >also openai: 'we cannot rule out that de-identified data from their usage helped improve our models' they stole it lmao"
A repercussão não ficou restrita a resumos da cronologia — também tomou um tom mais cético em relação ao próprio valor científico do feito. O usuário Mehdi (@BetterCallMedhi) publicou uma crítica dura à forma como a OpenAI apresentou o resultado:
"claiming that you solved navier stokes because 10000 agents ran in circles for 88hours on a multimillion dollar gpu cluster to formalize in lean a blowup case under controlled external forcing is pure scientific vulgarity (...) behind the theatrical PR claim lies the crude reality of brute force test time compute scaling burning hundreds of billions of synthetic tokens across a massive inference flux to coordinate 10000 ephemeral agents running recursive verification loops is not cognitive illumination"
As publicações ilustram como parte da comunidade técnica recebeu o anúncio com desconfiança dupla: tanto em relação à ética por trás da disputa de créditos quanto ao mérito de apresentar um resultado obtido por força bruta computacional como um "avanço cognitivo" da inteligência artificial.
Por que isso importa
Para além da disputa pessoal entre pesquisadores, o episódio expõe uma tensão estrutural que tende a se repetir: à medida que cientistas e pesquisadores passam a usar ferramentas de IA generativa — como Codex, Claude ou ChatGPT — para desenvolver trabalhos originais e sigilosos, cresce a pergunta sobre quem realmente é dono desse conhecimento, e se as próprias empresas que fornecem essas ferramentas podem, direta ou indiretamente, se beneficiar do conteúdo inserido por seus usuários antes que ele seja publicado.
Também fica evidente o quanto a "corrida" entre laboratórios de IA — motivada por rumores e disputa de prestígio — pode levar a decisões de alocar recursos computacionais massivos (na casa de dezenas de milhões de dólares) para problemas que, em tese, poderiam ser resolvidos com mais tempo e colaboração aberta entre os grupos de pesquisadores envolvidos.
Por ora, o resultado da OpenAI segue sem validação independente da comunidade matemática, e a prova mais avançada de Buckmaster e Alpöge sobre o problema central de Navier-Stokes ainda não foi publicada, à espera de uma verificação final em Lean.
Fontes e leitura complementar
- OpenAI — On the Navier–Stokes Millennium Prize Problem
- TechCrunch — OpenAI fought dirty on career-making math problem, says NYU mathematician
- Fortune — OpenAI says it cracked Navier-Stokes, one of math's grand challenges
- Axios — OpenAI's historic math solution overshadowed by credit controversy
- Engadget — What's going on with OpenAI and the Navier-Stokes controversy?
- Decrypt — OpenAI Says It Solved a $1M Math Problem. A Rival Mathematician Says He Did It First
- Dataconomy — NYU Professor Challenges Origin Of OpenAI's AI Proof
- VentureBeat — OpenAI solves longstanding math problem with 10,000-agent swarm
- CoinDesk — OpenAI says 10,000 AI agents solved a $1 million 'Navier-Stokes' math problem